
Table des matières
Dans l'article précédent, j'ai montré mon erreur : 226 fonctions SQL cachées dans ma base de données. L'IA ne voit rien. Je ne vois rien. Chaque modification est un risque.
Voici l'outil qui m'aurait évité ça.
C'est quoi un ORM ?
ORM = Object-Relational Mapping. En français : un traducteur.
Ton code parle TypeScript. Ta base de données parle SQL. Les deux ne se comprennent pas directement.
L'ORM, c'est l'interprète au milieu :
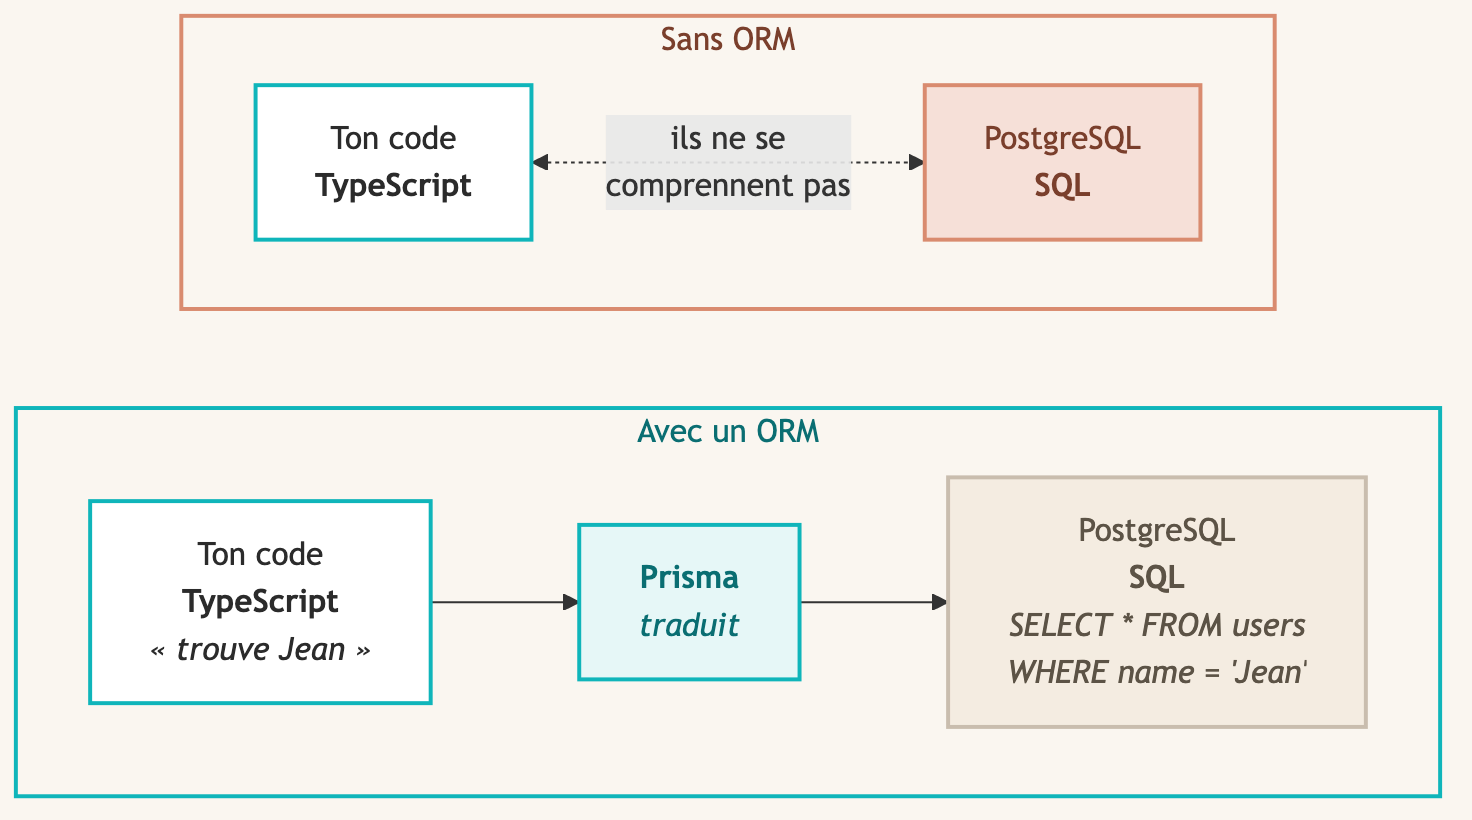
Tu écris du TypeScript lisible. Prisma génère le SQL pour toi.
Le schema : ta source de vérité
Avec Prisma, tu commences par décrire tes données dans un fichier schema.prisma :
model User {
  id        String   @id @default(uuid())
  name      String
  email     String   @unique
  createdAt DateTime @default(now())
  jobs      Job[]    // Un user peut avoir plusieurs jobs
}

model Job {
  id     String @id @default(uuid())
  title  String
  salary Int
  user   User   @relation(fields: [userId], references: [id])
  userId String
}
C'est lisible. Même sans connaître Prisma, tu comprends :
- Un
Usera un nom, un email, une date de création - Un
Userpeut avoir plusieursJob - Un
Jobappartient à unUser
Le truc magique : tu modifies ce fichier, tu lances une commande, et Prisma met à jour ta base de données.
npx prisma migrate dev --name "ajout-champ-telephone"Prisma compare ton schema avec ta base. Il génère le SQL nécessaire. Tu n'écris jamais de SQL toi-même.
Les types générés automatiquement
C'est là que Prisma devient puissant.
Quand tu lances npx prisma generate, Prisma crée des types TypeScript basés sur ton schema. Automatiquement.
Résultat dans ton éditeur :
const user = await prisma.user.findUnique({
  where: { id: userId }
})

// Ton éditeur SAIT que user a ces propriétés :
user.id        // ✅ suggéré
user.name      // ✅ suggéré
user.email     // ✅ suggéré
user.createdAt // ✅ suggéré

user.telephone // ❌ souligné en rouge (n'existe pas)
Avec Supabase sans Prisma, tu dois créer les types toi-même. Ou les générer avec un outil séparé. Et si tu oublies de les mettre à jour après un changement de schema... les erreurs arrivent en production.
Avec Prisma, les types sont toujours synchronisés avec ta base. Impossible de se tromper.
Les requêtes lisibles
Voici la même opération, avec et sans Prisma.
Sans Prisma (RPC Supabase) :
-- Quelque part dans tes migrations SQL
CREATE FUNCTION get_user_with_jobs(p_user_id uuid)
RETURNS TABLE(id uuid, name text, email text, jobs jsonb) AS $$
BEGIN
  RETURN QUERY
    SELECT u.id, u.name, u.email,
      COALESCE(jsonb_agg(jsonb_build_object('id', j.id, 'title', j.title))
        FILTER (WHERE j.id IS NOT NULL), '[]'::jsonb) as jobs
    FROM users u LEFT JOIN jobs j ON j.user_id = u.id
    WHERE u.id = p_user_id GROUP BY u.id;
END; $$;
Pas besoin de savoir lire ce SQL. C'est justement le problème : personne ne le lit, et c'est là-dedans que vit la logique de ton app.
// Dans ton code TypeScript
const { data } = await supabase.rpc('get_user_with_jobs', { p_user_id: userId })
// Qu'est-ce que "data" contient ? Aucune idée sans lire le SQL.
Avec Prisma :
const user = await prisma.user.findUnique({
  where: { id: userId },
  include: { jobs: true }  // Inclut les jobs automatiquement
})

// user.name ✅
// user.jobs[0].title ✅
// Tout est typé. Tout est visible.
La logique est dans ton code. L'IA la voit. Tu la vois. Les tests sont faciles à écrire.
L'exemple concret : le cooldown
Tu te souviens de l'exemple dans l'article précédent ? La fonction SQL qui vérifie un cooldown de 30 jours avant de modifier un nom.
Avant (logique cachée en SQL) :
// Le code ne montre rien
await supabase.rpc('update_user_name', { p_user_id: userId, p_name: name })
Après (logique visible avec Prisma) :
async function updateUserName(userId: string, name: string) {
  // 1. Récupérer l'utilisateur
  const user = await prisma.user.findUniqueOrThrow({
    where: { id: userId }
  })

  // 2. Vérifier le cooldown (LA RÈGLE EST VISIBLE)
  if (user.lastNameChange) {
    const daysSince = differenceInDays(new Date(), user.lastNameChange)
    if (daysSince < 30) {
      throw new Error(`Attends encore ${30 - daysSince} jours`)
    }
  }

  // 3. Mettre à jour
  return prisma.user.update({
    where: { id: userId },
    data: {
      name,
      lastNameChange: new Date()
    }
  })
}
Quelqu'un qui lit ce code comprend immédiatement :
- Il y a une règle de 30 jours
- Elle s'applique au changement de nom
- Le message d'erreur est clair
L'IA comprend aussi. Elle peut modifier la règle sans casser autre chose.
Quand garder Supabase
Prisma ne remplace pas tout. Supabase reste utile pour :
| Fonctionnalité | Utiliser |
|---|---|
| Authentification | Supabase Auth |
| Stockage de fichiers | Supabase Storage |
| Temps réel | Supabase Realtime |
| Sécurité par ligne (RLS) | Supabase |
| Requêtes géographiques | PostGIS (via Supabase) |
| Cron jobs | pg_cron (via Supabase) |
Les deux peuvent cohabiter. Tu utilises Prisma pour ta logique métier (CRUD, validations, calculs). Tu utilises Supabase pour les services (auth, storage, realtime).
// Auth avec Supabase
const { data: session } = await supabase.auth.getSession()

// Logique métier avec Prisma
const user = await prisma.user.findUnique({
  where: { id: session.user.id }
})
Le meilleur des deux mondes.
Comment démarrer avec Prisma
Si tu veux essayer, voici les étapes de base :
# 1. Installer Prisma
npm install prisma @prisma/client

# 2. Initialiser
npx prisma init

# 3. Configurer ta base dans .env
DATABASE_URL="postgresql://user:password@localhost:5432/mydb"

# 4. Créer ton schema (prisma/schema.prisma)

# 5. Appliquer à la base
npx prisma db push

# 6. Générer les types
npx prisma generate
Mais en pratique, je ne fais pas ça moi-même.
En vibecoding, c'est l'IA qui écrit le code. Le problème : elle ne connaît pas ta stack par défaut. Elle peut mélanger Prisma et Supabase n'importe comment.
Ma solution : je lui donne des rules. Des fichiers qui expliquent comment utiliser ma stack, et qui ne se chargent que quand ils sont pertinents.
Par exemple, ma rule prisma-supabase.md, section architecture :
| Action | Outil |
|---|---|
| CRUD server-side | Prisma |
| CRUD client-side avec RLS | Client Supabase |
| Relations complexes, transactions | Prisma |
| Realtime, storage, auth | Client Supabase |
Et ma rule database-workflow.md qui explique quelle commande utiliser :
| Commande | Usage |
|---|---|
db push | Dev rapide, prototype |
migrate dev | Migrations versionnées |
migrate deploy | Production CI/CD |
L'IA lit ces rules. Elle sait que Prisma c'est pour le CRUD server-side, Supabase c'est pour l'auth et le realtime. Elle ne mélange plus.
C'est ça le vibecoding : tu configures l'IA une fois, elle applique les bonnes pratiques partout.
La logique métier, c'est dans le code. Pas dans la base.
Prisma rend ça naturel. Tu écris du TypeScript lisible. Les types sont générés. Les erreurs sont détectées avant la production.
Si j'avais utilisé Prisma dès le début, je n'aurais pas 226 fonctions SQL à migrer aujourd'hui.
Ne fais pas comme moi.
Commentaires