
Table des matières
J'ai construit une base de 280 randonnées en Guadeloupe. Je n'ai pas écrit un seul pipeline de scraping.
Pas de cron job, pas de workflow n8n, pas de browserless à configurer. J'ai donné à mon IA un accès au web, le contexte de mon projet, et je l'ai laissée chercher.
Ça paraît trop simple ? C'est pourtant ce que je fais maintenant pour tous mes projets qui ont besoin de données du web. Et ça change tout par rapport au scraping "classique" que je pratiquais avant.
Deux façons de scraper
Avant, quand j'avais besoin de données du web, je montais un pipeline. Un workflow n8n avec browserless, des cookies à gérer, du stealth mode à activer, des scripts Playwright qui cassent dès qu'un site change son HTML. J'en parlais dans mon article sur le scraping en 2025.
Ça marche. Mais c'est lourd. Et surtout, c'est fait pour du scraping continu : surveiller un site, alimenter un flux de données, monitorer des changements.
Sauf que dans la plupart de mes projets, j'ai pas besoin de ça. J'ai besoin d'un tour d'horizon. Une fois. Faire le tour de ce qui existe sur le web, capturer les données intéressantes, et passer à autre chose.
C'est là que le scraping assisté entre en jeu. Tu donnes à ton IA un accès au web via un MCP, et elle fait les recherches pour toi.
Mais pour que ça marche vraiment, il faut deux choses : un MCP de scraping et un agent.
La chaîne : MCP, agent, contexte
Un MCP, c'est un outil qu'on branche sur son IA. Dans mon cas, j'utilise Bright Data : un MCP qui donne à Claude Code l'accès au web. Recherche, scraping, extraction de pages entières en markdown.
Pourquoi Bright Data ? Le modèle pay-as-you-go. Tu payes ce que tu consommes, pas d'abonnement. Et leur mode scrape as markdown renvoie du contenu propre, directement exploitable par l'IA. Firecrawl est une excellente alternative si tu préfères un abonnement classique, avec un free tier pour tester. Leur output markdown est aussi très bon.
Mais le MCP seul, ça ne suffit pas. Si tu demandes à Claude Code de "scraper le web pour trouver des randonnées en Guadeloupe", il va faire une ou deux recherches et te donner un résultat moyen.
Le vrai game changer, c'est l'agent.
Un agent, c'est un sous-processus autonome. Tu lui donnes une mission, le contexte de ton projet, et les outils dont il a besoin (ici, le MCP Bright Data). Il lance ses propres recherches, scrape les pages pertinentes, compare les sources, élimine le bruit, et te livre une synthèse.
Et il y a un bonus énorme : l'agent tourne dans son propre contexte. Il ne pollue pas ta conversation principale. Tu peux lancer plusieurs agents en parallèle sans exploser ta fenêtre de contexte.
C'est comme avoir un stagiaire qui fait des recherches pour toi. Sauf qu'il lit 50 articles en 2 minutes et te résume l'essentiel.
Du coup, j'utilise cette approche pour plein de cas de figure. Quand j'ai une question UX, parce que les bonnes pratiques dépendent énormément du secteur et que l'IA toute seule n'a pas forcément les références à jour. Quand je dois choisir une techno et que je veux comparer ce qui se fait vraiment. Quand je fais de la veille sur un sujet précis. À chaque fois, c'est le même schéma : je donne le contexte de mon projet à l'agent, il fait les bonnes recherches parce qu'il comprend ce que je construis, et il me livre une synthèse débarrassée du bruit.
Le scraping de données pour rando-guadeloupe, c'est juste le cas le plus spectaculaire. Mais au quotidien, c'est surtout un outil de recherche.
En pratique : rando-guadeloupe
Mon projet : une app pour trouver des randonnées en Guadeloupe. J'avais besoin de données. Beaucoup de données. Noms des sentiers, distances, dénivelés, traces GPX, descriptions.
J'ai lancé mon agent deep-search avec le contexte du projet. Il savait ce que je cherchais : des sites avec des fiches de randonnées en Guadeloupe, si possible avec des traces GPX téléchargeables.
Il a fait le tour du web. Il a trouvé RandoGPS, FranceTourisme, le Geotrek du Parc National. Il a scrapé les pages via Bright Data et Firecrawl, comparé les sources, identifié les doublons, et m'a livré une synthèse avec les meilleurs sites et leurs données.
Pour certaines sources, l'extraction via MCP ne suffisait pas. Des fichiers GPX à télécharger, des sites avec du shadow DOM, des pages imbriquées dans des iframes. Là, Claude Code m'a généré des scripts Playwright sur mesure pour capturer ce que le MCP ne pouvait pas atteindre.
Ces scripts, ils sont fragiles. C'est exactement ce que je disais dans mon article précédent : un script Playwright, ça casse dès qu'un site change. Mais c'est pas grave. Je n'en avais besoin qu'une fois. One-shot.
Résultat ? ~280 randonnées en base. Trois sources agrégées, dédupliquées, nettoyées. Sans un seul pipeline à maintenir.
One-shot vs automatisé : la bonne question
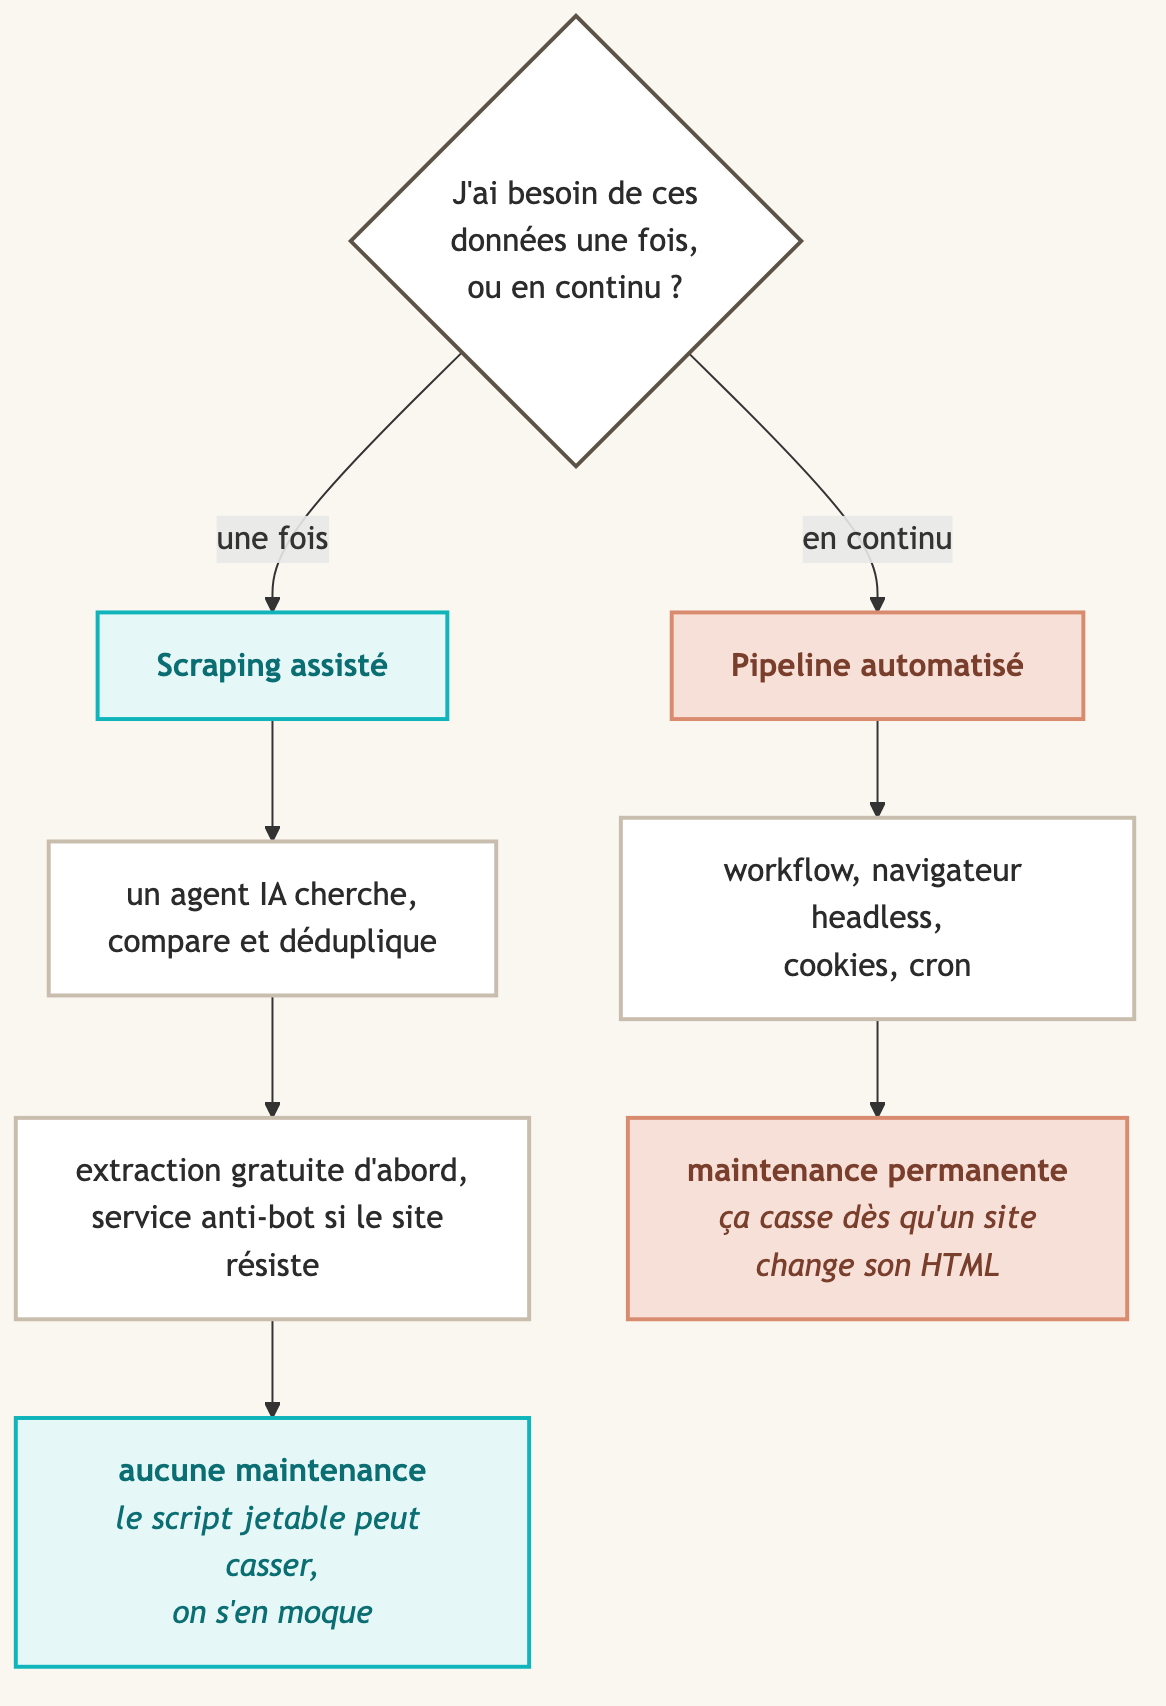
La question à se poser, c'est pas "quel outil de scraping utiliser ?". C'est "j'ai besoin de ces données une fois ou en continu ?"
One-shot (scraping assisté) : tu bootstrappes un projet, tu fais un tour d'horizon, tu alimentes une base de données initiale. L'IA fait les recherches, agrège, résume. Pas de maintenance après. C'est ce que j'ai fait pour rando-guadeloupe, et c'est ce que je fais pour toutes mes recherches approfondies.
Automatisé : tu surveilles un site, tu alimentes un flux continu, tu monitores des changements. Là, tu as besoin d'un vrai pipeline (n8n, browserless, cron jobs). Ça demande de la maintenance.
Le truc, c'est que la plupart du temps, on monte un pipeline automatisé pour un besoin qui est en fait one-shot. On passe 3 heures à configurer browserless, gérer les cookies, activer le stealth mode... alors qu'on avait juste besoin de récupérer des données une fois.
Le scraping a changé. L'IA comprend ce qu'elle lit. Elle ne fait pas du parsing HTML brut, elle agrège et déduplique intelligemment. Et quand elle ne peut pas extraire via MCP, elle te génère un script jetable pour le cas spécifique.
Donne-lui les bons outils, le bon contexte, et laisse-la chercher. Que ce soit pour alimenter une base de données, choisir une techno, ou simplement comprendre un domaine que tu ne maîtrises pas encore.
Mise à jour : j'ai lâché le MCP
Avec le recul, la thèse de l'article n'a pas bougé. One-shot contre automatisé, c'est toujours la bonne question à se poser en premier. Par contre l'outillage que je décris a changé sur deux points.
Le MCP a sauté, l'API REST reste
J'utilisais le MCP Bright Data. Je suis passé à leur API REST directe.
La raison n'est pas celle qu'on croit. Un MCP déclaré dans un mcp.json est parfaitement portable : Claude Code, OpenCode, Cursor et les autres savent tous le lire. Le mien n'était pas là. Il était branché comme connecteur dans claude.ai, et un connecteur claude.ai ne sort jamais de claude.ai.
Le jour où j'ai voulu scraper depuis mon VPS, ou depuis un script bash sans IA du tout, il ne me servait plus à rien. Un appel HTTP, si. La leçon n'est donc pas que les MCP sont enfermés, c'est que l'endroit où tu installes le tien décide de ce que tu pourras en faire ailleurs.
Et en allant lire le code du serveur MCP officiel, j'ai vu qu'il fait exactement les mêmes appels REST en interne. Même endpoint, même payload. Je ne perds donc aucune capacité, et je gagne le poids des schémas d'outils qui n'encombrent plus mon contexte.
Avant Bright Data, il y a gratuit
Aujourd'hui ma chaîne commence par Defuddle, un outil en ligne de commande qui extrait une page en markdown propre. npx defuddle parse <url> --markdown, c'est tout. Gratuit, rapide, et ça passe sur la grande majorité des sites. Bright Data n'intervient qu'en second, quand Defuddle se fait jeter.
Ce qui m'amène à la nuance que je n'avais pas comprise en écrivant cet article : Bright Data résout un problème d'anti-bot, pas un problème d'adresse IP.
J'ai testé les mêmes URLs depuis ma connexion perso et depuis un VPS. Les sites blindés (G2, Indeed, Amazon) bloquent Defuddle des deux côtés, et Bright Data les ouvre. Mais YouTube fait l'inverse : Defuddle sort le transcript complet depuis chez moi, et se prend un 429 depuis le VPS. Là, un simple proxy suffit et payer Bright Data est un détour coûteux.
Les deux couches ne se remplacent pas. Un proxy ne débloque pas un challenge anti-bot, et un service anti-bot est un marteau-pilon pour un problème de réputation d'IP.
Dernier point : j'avais cité un prix pour Firecrawl. Je ne le referai plus, ces tarifs bougent plusieurs fois par an. Va voir leur page au moment où tu lis.
Commentaires