
Table des matières
J'envisage de recommencer mon site de zéro.
Pas parce que la stack est mauvaise. Next.js, Supabase, TypeScript - c'est solide. J'ai construit un vrai produit avec. Des utilisateurs. Du trafic. Ça tourne.
Le problème ? J'ai 226 fonctions SQL dans ma base de données.
Et aujourd'hui, chaque modification d'architecture me prend des jours au lieu d'heures.
Ce que j'ai fait
Quand j'ai commencé avec Supabase, j'ai suivi la doc. Et la doc, elle t'encourage à créer des RPC (Remote Procedure Calls) - des fonctions SQL que tu appelles depuis ton code.
Tu veux chercher des offres d'emploi avec des filtres ? Crée une fonction search_jobs. Tu veux vérifier un cooldown avant de modifier un profil ? Crée une fonction update_user_name qui gère tout.
Au début, ça marchait bien. Chaque feature = une nouvelle fonction SQL. Clean.
Sauf qu'au bout de 2 ans, je me suis retrouvé avec ça :
| Catégorie | Nombre de fonctions |
|---|---|
| CRUD basique | 47 |
| Recherche | 23 |
| Auth & sécurité | 22 |
| Agrégations | 18 |
| Messaging | 14 |
| Autres | 102 |
| Total | 226 |
226 fonctions. Dont peut-être 20 qui ont vraiment besoin d'être en SQL.
Si tu veux comprendre comment chaque élément de la stack s'articule (JavaScript, TypeScript, React, Next.js, Supabase, Prisma), j'en parle en détail dans cet article sur la stack web moderne.
Pourquoi c'est devenu un problème
L'IA ne voit rien
Quand je demande à Claude de modifier une feature, il doit lire le code TypeScript. Mais la logique métier ? Elle est cachée dans une fonction SQL, quelque part dans mes migrations.
L'IA doit faire des allers-retours. Lire une fonction. Puis une autre. Puis une autre. Elle ne voit jamais l'ensemble.
Résultat : elle simplifie mes RPC sans comprendre pourquoi elles sont complexes. Elle oublie un cas de figure. Et moi, je ne m'en rends compte qu'en prod, quand un utilisateur me signale un bug.
Je suis aveugle.
Modifier = tout casser
Ma fonction search_jobs fait 175 lignes de SQL. Avec du SQL dynamique, des filtres géographiques, du scoring.
Elle en est à la version 6. search_jobs_v6.
Chaque fois que j'ai voulu ajouter un filtre, j'ai dû :
- Lire 175 lignes de SQL pour comprendre ce qui se passe
- Modifier sans casser les 15 autres cas de figure
- Tester manuellement (pas de tests unitaires en SQL)
- Prier
Impossible de migrer
Aujourd'hui, je voudrais passer sur Prisma. Un ORM moderne qui génère des types TypeScript automatiquement.
Le problème : j'ai 46 appels supabase.rpc() répartis dans 29 fichiers. Chaque RPC est une dépendance. Pour migrer, je dois toutes les réécrire.
C'est des semaines de travail. Juste pour réparer une erreur d'architecture.
Ce que j'aurais dû faire
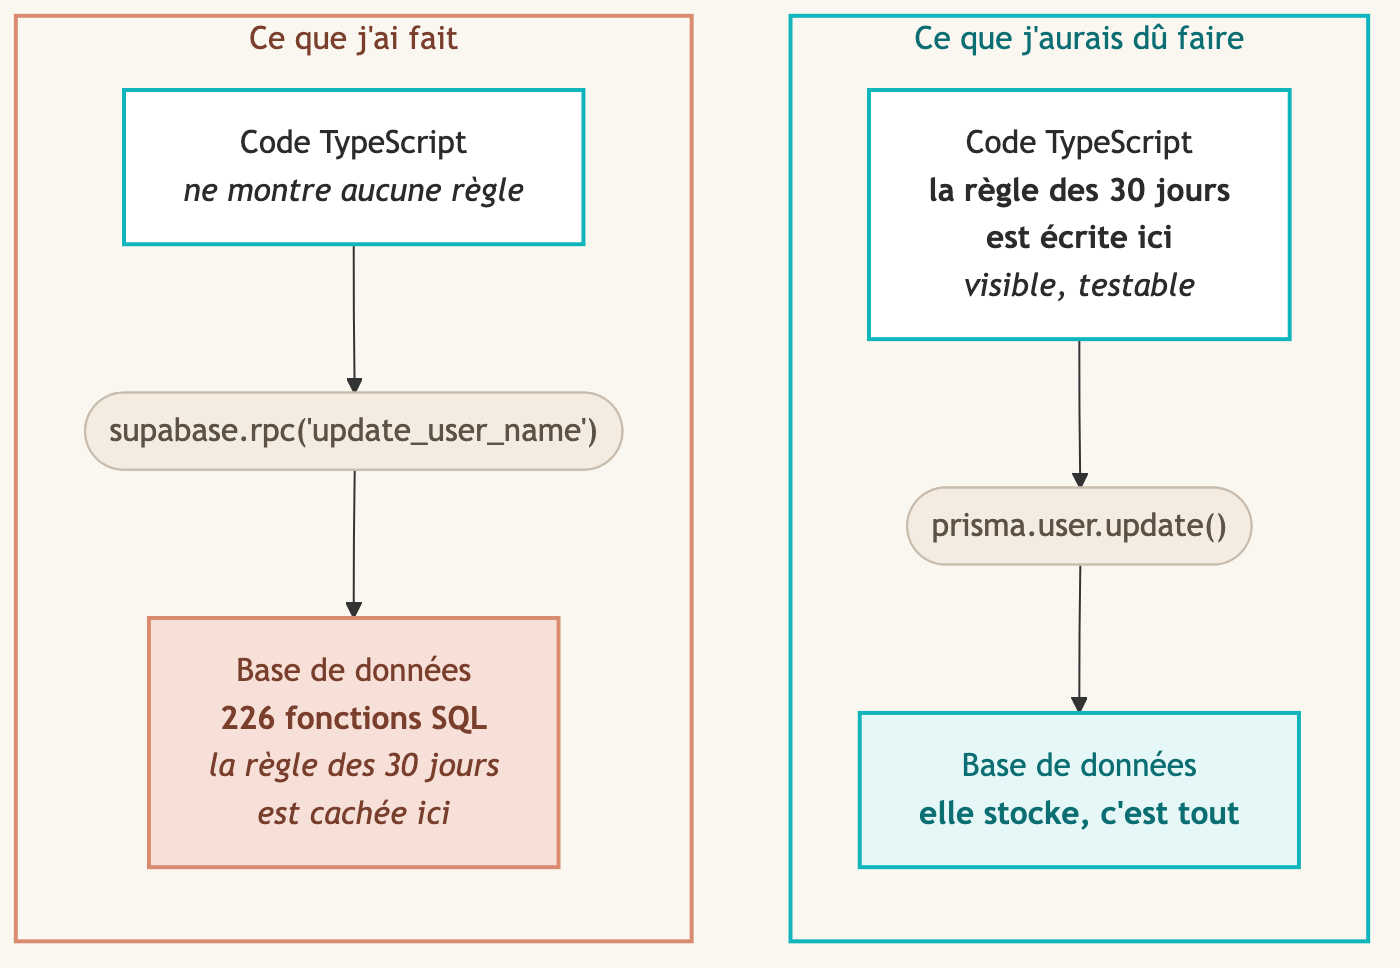
La règle est simple :
La base de données stocke. Le code décide.
Concrètement :
| Mettre en SQL ✅ | Mettre en TypeScript ✅ |
|---|---|
| PostGIS (calculs géographiques) | CRUD (create, read, update, delete) |
| Agrégations sur 100k+ lignes | Validations métier |
| Triggers d'audit | Calculs et transformations |
| Cron jobs (pg_cron) | Logique conditionnelle |
Exemple concret
Voici ce que j'ai fait :
-- Fonction SQL cachée dans une migration
CREATE FUNCTION update_user_name(p_user_id uuid, p_name text)
RETURNS void AS $$
BEGIN
  IF EXISTS (
    SELECT 1 FROM users
    WHERE id = p_user_id
    AND last_change > NOW() - INTERVAL '30 days'
  ) THEN
    RAISE EXCEPTION 'Cooldown actif';
  END IF;
  UPDATE users SET name = p_name WHERE id = p_user_id;
END; $$;
Et dans mon code TypeScript :
// Le code ne montre rien de la logique
await supabase.rpc('update_user_name', { p_user_id: userId, p_name: name })
Impossible de savoir qu'il y a une règle de 30 jours en lisant le code.
Voici ce que j'aurais dû faire :
async function updateUserName(userId: string, name: string) {
  const user = await prisma.user.findUnique({ where: { id: userId } })

  // La règle métier est VISIBLE
  if (user.lastChange) {
    const daysSince = differenceInDays(new Date(), user.lastChange)
    if (daysSince < 30) {
      throw new Error(`Attends encore ${30 - daysSince} jours`)
    }
  }

  await prisma.user.update({
    where: { id: userId },
    data: { name, lastChange: new Date() }
  })
}
L'IA voit tout. Je vois tout. Les tests sont faciles à écrire.
Comment éviter cette erreur
Avant de créer une RPC, pose-toi une question :
"Est-ce que je peux le faire en TypeScript ?"
Si oui → fais-le en TypeScript.
Si non (PostGIS, agrégations lourdes, cron) → crée la RPC, mais avec un wrapper TypeScript documenté.
Pour le CRUD et la logique métier, utilise un ORM comme Prisma ou Drizzle. Tu auras :
- Des types générés automatiquement
- Une logique visible et testable
- Une architecture qui évolue sans douleur
C'est le sujet du prochain article : Prisma, l'ORM qui rend la logique visible.
Prisma est la constante, quelle que soit la base en dessous, et c'est justement ce qui rend la bascule possible : la logique vit dans le code et pas dans la base, donc passer de PostgreSQL à SQLite ne réécrit pas l'application.
Attention, ce n'est pas un remplacement terme à terme. En quittant Supabase tu perds l'authentification, le stockage de fichiers, le temps réel et les RLS : il faut les reprendre à ta charge. Le calcul vaut le coup sur un projet modeste, beaucoup moins dès que tu as besoin de ces briques ou d'une vraie base sous charge. Pour les gros projets, je reste sur Supabase.
Reste une asymétrie qui vaut d'être connue avant de choisir : passer de SQLite à Supabase plus tard se fait sans douleur, l'inverse beaucoup moins. Plus tu t'appuies sur ce que Supabase offre en propre, plus tu y es attaché, et c'est exactement ce qui m'est arrivé avec les 226 fonctions SQL dont parle cet article. Commencer petit garde la porte ouverte.
La stack était bonne. L'architecture non.
Si tu débutes avec Supabase, ne fais pas comme moi. Garde ta logique dans le code. La base de données, c'est pour stocker.
Commentaires