
Table des matières
J'ai été un des premiers à tester les Skills quand ils sont sortis. Et je les ai abandonnés.
Quelques mois plus tard, je suis retombé dessus par hasard. Et j'ai compris ce que j'avais raté.
Dans mes articles précédents, je parlais du CLAUDE.md et des 3 boosters (Commands, MCP, Agents). Le problème récurrent : le contexte. Chaque outil que tu ajoutes prend de la place.
Les Skills promettent de résoudre ça. Mais pas de la façon dont tu l'imagines.
Le problème : tout est dispersé (et tout prend de la place)
Avant les Skills, j'avais mes outils bien rangés :
- Commands : des prompts préfaits que je déclenchais avec
/ma-commande - Rules : des conventions chargées selon les fichiers que je modifiais
- MCP : des outils externes avec leur documentation
Le problème, c'est que chacun avait ses limites.
Les Commands, c'est pratique. Mais c'est juste un prompt. Si ta commande a besoin de documentation lourde (une API reference de 500 lignes, un style guide complet), tu fais quoi ? Tu colles tout dans le prompt ? Ça explose ton contexte. Tu mets la doc ailleurs ? Claude ne sait pas qu'elle existe, il faut penser à lui référencer. Et tu es obligé de te trimballer ta doc en plus de tes config Claude.
Les Rules, c'est malin : elles se chargent selon le path des fichiers. Mais seulement selon le path.
Exemple : J'ai une rule de 170 lignes pour écrire des notes Obsidian. Le problème c'est qu'elle ne se déclenche que si je modifie des fichiers dans le bon dossier. Quand Claude utilise mon MCP Obsidian pour créer des notes, cette rule ne se charge jamais. Il écrit des notes sans connaître mes conventions.
Les MCP, ils donnent des outils à Claude. Mais chaque MCP activé, c'est de la documentation qui occupe le contexte. Et si tu veux que Claude utilise un MCP d'une certaine manière, tu dois mettre les instructions... dans une Command ou une Rule. Retour à la case départ.
Résultat : mes instructions étaient dans les Commands, ma doc dans des fichiers séparés, mes conventions dans les Rules. Tout fonctionnait mais pas de manière optimale.
Ce que les Skills apportent vraiment
Si tu connais les GPTs personnalisés de ChatGPT ou les projets de Claude Desktop, tu as déjà le concept. Un skill, c'est pareil : un assistant spécialisé avec sa documentation à disposition, intégré directement dans ton projet de code.
Sauf que c'est mieux. Imagine que quand tu parles à Claude, il puisse invoquer un spécialiste s'il pense que celui-ci va mieux répondre que lui. Tu demandes de créer une note Obsidian ? Claude détecte que le skill "Obsidian" est pertinent, le charge, et utilise les bonnes conventions. Tu n'as rien déclenché manuellement.
C'est des assistants surqualifiés, avec leur doc, leurs scripts, leurs conventions, et qui ne se manifestent que quand on a besoin d'eux.
Tout au même endroit
Un Skill, c'est un dossier. Dedans, tu mets tout ce dont Claude a besoin pour une tâche :
mon-skill/
├── SKILL.md           # Instructions principales
├── references/
│   ├── api-guide.md   # Doc lourde (chargée à la demande)
│   └── examples.md    # Exemples
└── scripts/
    └── validate.sh    # Scripts exécutables
Le SKILL.md, c'est le point d'entrée. Tu y mets les instructions, et tu références les autres fichiers. Claude ne les charge que s'il en a besoin.
Fini la dispersion. Ta commande, ta doc, tes scripts : tout est au même endroit. Et c'est ça le vrai changement.
Mon cas concret : j'ai des "assistants" dans Claude Code : blog, YouTube, productivité... Avant les skills, chaque assistant c'était : une commande dans .claude/commands/, des fichiers de doc dans un autre dossier, et Claude devait tout lire au début de session. Résultat : dès que la conversation avançait un peu, il commençait à oublier ce qu'il avait lu. La fenêtre de contexte était saturée avant même qu'on commence à travailler.
Avec un skill, tout est dans un seul dossier. L'instruction, la doc associée, les scripts. C'est beaucoup plus simple à organiser et à maintenir. Quand tu commences à avoir des workflows complexes dans Claude Code, gérer plein de fichiers à différents endroits devient vite un cauchemar. Là, tu gères une brique au même endroit.
L'autoload par contexte : le vrai différenciateur
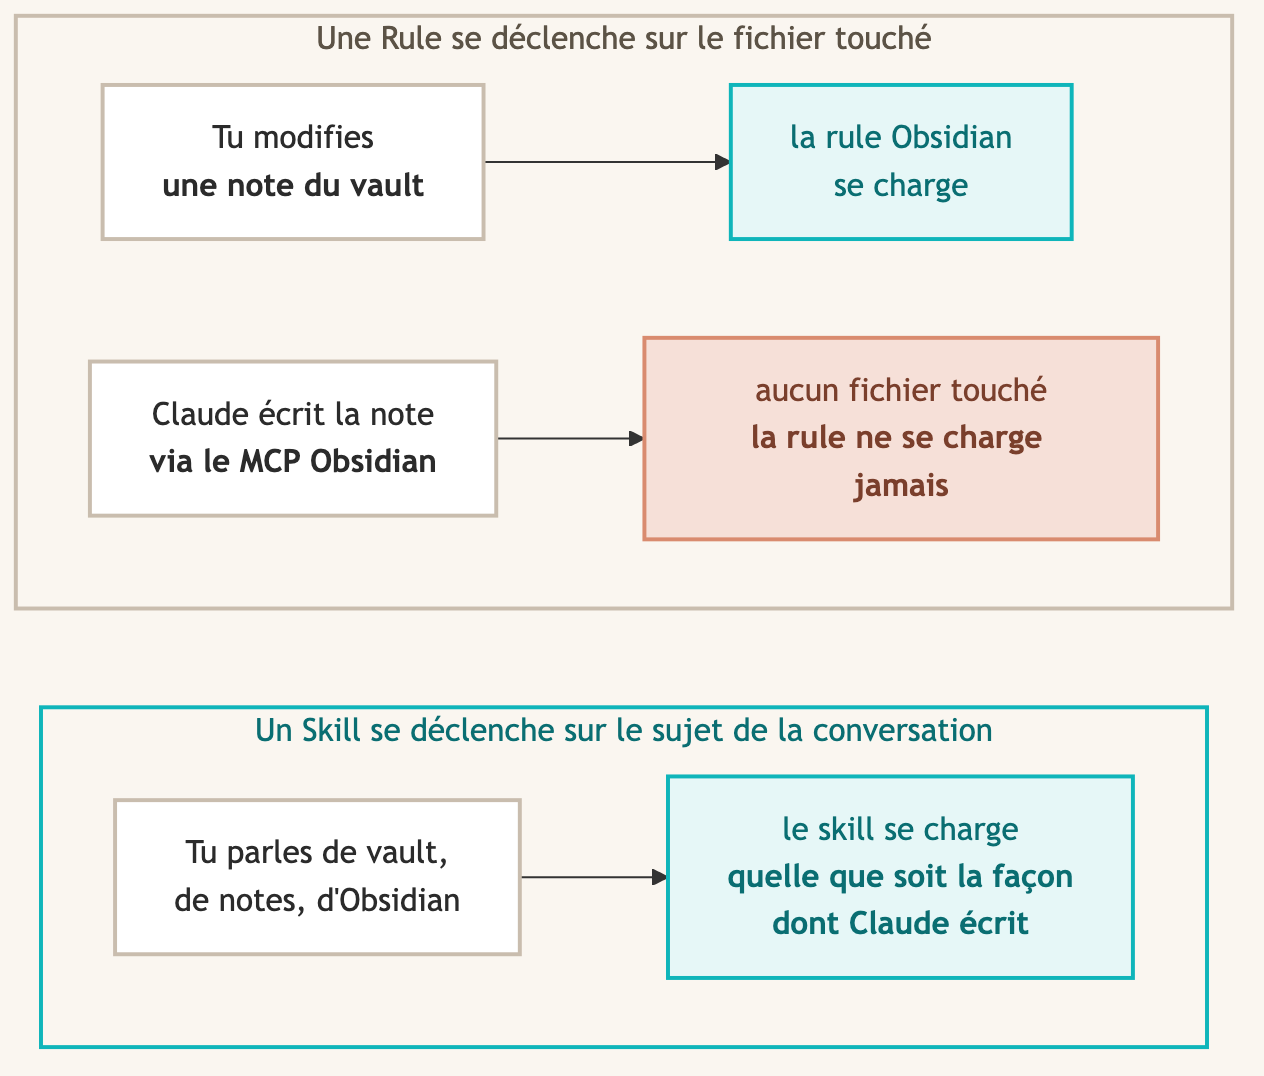
Les Rules, c'est du progressive disclosure basé sur le path : tu modifies un fichier .tsx, la rule React se charge. C'est déterministe et fiable.
Les MCP aussi font du progressive disclosure maintenant : Claude charge les descriptions des outils, et ne charge le détail que quand il en a besoin.
Les Skills ajoutent une dimension que ni les Rules ni les MCP ne proposent : le chargement basé sur le contexte de ta conversation.
Claude lit les descriptions des skills au démarrage. Si ta conversation tourne autour d'Obsidian, il charge le skill Obsidian. Si tu parles de déploiement, il charge le skill deploy. Ce n'est pas lié aux fichiers que tu modifies, mais à ce que tu fais.
Et le truc bien pensé : avec disable-model-invocation: true, tu peux désactiver ce comportement skill par skill. Zéro coût en contexte jusqu'à ce que toi tu décides de l'invoquer avec /mon-skill.
Reprenons mon exemple : ma rule Obsidian de 170 lignes ne se déclenchait jamais quand Claude utilisait le MCP Obsidian (parce que les rules matchent sur le path, pas sur le contexte). En skill, avec une bonne description mentionnant "obsidian", "vault", "notes", Claude la charge automatiquement quand il travaille avec le vault. Exactement ce que je voulais.
Tes commandes sont déjà des skills
Un truc que j'ai découvert récemment : les Commands et les Skills ont été fusionnés. Ton fichier .claude/commands/review.md et un skill .claude/skills/review/SKILL.md créent tous les deux /review et fonctionnent pareil.
Tes .claude/commands/ continuent de marcher. Mais les skills sont recommandés parce qu'ils supportent des choses en plus : les fichiers de référence, le contrôle d'invocation, le chargement automatique.
D'ailleurs, si tu as remarqué que certaines de tes commandes se déclenchent parfois toutes seules, c'est pour ça. Elles sont traitées comme des skills.
Les scripts : pratique, mais pas verrouillé
Un skill peut embarquer des scripts que Claude exécute. Tu mets un fichier Python, Bash, ou Node dans le dossier du skill, tu le références dans ton SKILL.md, et Claude le lance quand il en a besoin.
C'est pratique pour des tâches simples : validation, génération, formatage.
Mais attention : contrairement à un MCP, Claude peut modifier ces scripts. Si quelque chose ne marche pas comme il veut, il va adapter le script à sa sauce. Pour des cas où tu veux protéger tes données (ton vault Obsidian, tes projets DaVinci), un MCP custom reste plus sûr parce que les outils sont verrouillés, Claude ne peut pas les changer.
Un mot sur la portabilité
Les skills peuvent être stockés en personnel (~/.claude/skills/) ou en projet (.claude/skills/). Perso, je ne m'embête pas avec l'installation globale. J'ai un template GitHub avec tous mes skills importants, et je le copie pour démarrer un nouveau projet. Tout reste en local dans le repo.
L'activation automatique : un faux problème
La promesse des skills, c'est que Claude détecte automatiquement quand les utiliser. Il lit la description du skill, et si ta conversation matche, il le charge.
En pratique, c'est non-déterministe. C'est du raisonnement LLM : parfois ça matche, parfois non. Ça dépend de la qualité de ta description et du contexte de la conversation.
Mais honnêtement, c'est un faux problème. Parce que dans beaucoup de cas, tu ne veux pas que ça s'active tout seul.
Imagine : tu as un skill de déploiement. Tu parles de "mettre en prod" dans la conversation. Tu veux vraiment que Claude décide seul de lancer le déploiement ? Non.
Et c'est là que le système est bien pensé. Tu as deux leviers :
disable-model-invocation: true: Claude ne peut pas l'invoquer. Toi seul décides avec/mon-skill. Parfait pour les actions critiques (déployer, publier, supprimer).- Sans ce flag : Claude peut l'invoquer automatiquement. Bien pour la documentation de référence, les conventions de code, les guides de style.
C'est le meilleur des deux mondes. Tu gardes le contrôle sur ce qui compte, et tu laisses Claude charger la doc quand il en a besoin.
Skills vs Rules vs Commands vs MCP : quand utiliser quoi
| Besoin | Outil | Pourquoi |
|---|---|---|
| Conventions universelles (50-80 lignes) | CLAUDE.md | Toujours chargé, à chaque message |
| Conventions par techno/dossier | Rules | Se charge selon le path des fichiers modifiés |
| Conventions par contexte d'usage | Skills (auto) | Se charge selon la conversation, pas le path |
| Workflows critiques (deploy, publish) | Skills en manuel (equivalent command) | disable-model-invocation: true = toi seul décides |
| Doc lourde + instructions | Skills | Tout au même endroit, chargé à la demande |
| Outils externes verrouillés avec mode d'emploi | MCP | Claude ne peut pas modifier les outils |
| Outils externes + méthodologie forcée | MCP custom | Tu contrôles les outils ET la manière de les utiliser |
La distinction clé entre Skills et MCP : les skills donnent de la connaissance (doc, conventions, workflows). Les MCP donnent des capacités (outils, accès à des services). Ils se complètent.
Et les skills ne remplacent pas les rules non plus. Les rules restent parfaites pour du matching déterministe sur les fichiers : "quand tu modifies un .tsx, utilise les Server Components par défaut". Ça, c'est fiable à 100%. Les skills, c'est pour tout ce qui dépend du contexte de ce que tu fais, pas des fichiers que tu touches.
Comment j'ai réorganisé mon setup
Concrètement, voici ce que ça a donné chez moi :
- Mes workflows restent en skills manuels :
/start,/plan,/implementavecdisable-model-invocation: true. Je contrôle quand ça se déclenche. - Ma doc lourde migre en skills auto : mes conventions Obsidian, mes guides de style, mes API references. Claude les charge quand le contexte s'y prête.
- Mes MCP custom restent des MCP là où le verrou compte vraiment : Ghost Optimized et celui qui pilote DaVinci. Obsidian Writer a depuis cédé la place à une ligne de commande, plus simple à appeler depuis n'importe où.
- Mes rules restent pour le path-matching : conventions TypeScript, React, styles par dossier.
Et il y a des features avancées que je n'ai pas encore explorées : les skills qui tournent dans des sous-agents isolés, l'injection dynamique de commandes shell, les arguments indexés... C'est documenté, ça existe, mais c'est du niveau expert, et je ne les ai toujours pas mises en pratique.
Les Skills ne remplacent rien. Ils rassemblent ce qui était dispersé (commandes, documentation, scripts) en un seul paquet portable qui ne prend de la place que quand tu en as besoin.
C'est moins sexy que "l'IA qui détecte automatiquement ce dont tu as besoin". Mais c'est honnête. Et c'est utile.
Pour voir comment tout ça s'organise dans un vrai projet, j'ai détaillé ma méthode de structuration, celle qui tient sur les gros projets.
Commentaires